
最近翻到 CPEM 全国电力设备管理网一篇甘肃电投张掖发电公司的智慧电厂报道,有一个细节比"320 路摄像机全接入""40 项 AI 算法上线"更值得琢磨:报道里明确写了,十月份这家电厂完成了误报样本归集与模型迭代,引入多语言过滤模型之后,算法识别准确率稳定保持在九成以上,告警效率和判定质量明显提升。来源:CPEM 全国电力设备管理网。
做视频 AI 的人都懂,这行真正难的不是把算法跑起来,而是跑起来之后怎么办。同一个月里,中国日报网报道的黄山移动化工园区项目在重大危险源区域做 7×24 小时视频 AI 动态监测,识别未戴安全帽、人员聚集、睡岗离岗;浙江电信在温州某电镀园区部署 299 路 AI 监测点位做烟火识别,走的还是复用存量国标摄像头的路线。三个案例行业不同,却指向同一件事:AI 视频识别进入规模化之后,误报治理才是决定系统能不能活下去的那道坎。
这篇按老规矩,用问题清单的方式把这堂"治理课"拆开看。
问题一:误报到底从哪来?
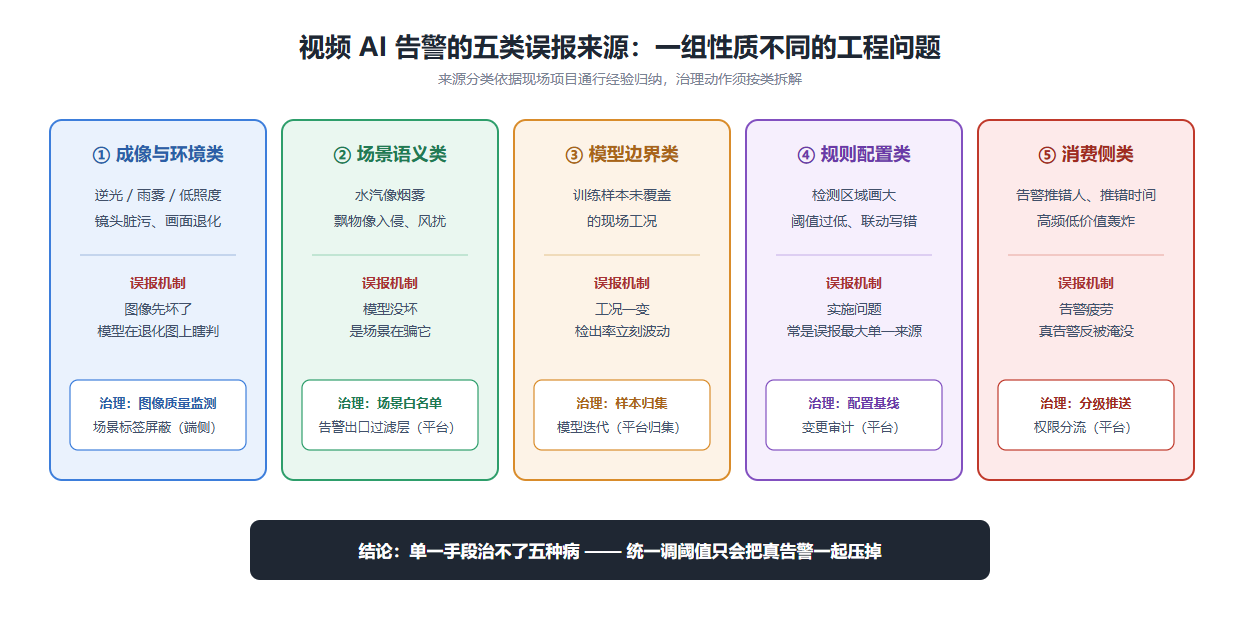
先把误报的来源摆上桌面。按现场项目的普遍经验,视频 AI 告警的误报大致可以归成五类,来源不同,治理动作也完全不同:
- 成像与环境类:逆光、雨雾、夜间低照度、镜头脏污导致的画面质量退化,模型在退化图像上瞎判。这类误报最冤枉——算法没错,是图像先坏了。
- 场景语义类:场景本身长得像告警目标。水汽看着像烟雾,飘过的塑料布看着像入侵人员,风吹动的安全帽挂在钩子上看着像有人未摘帽。模型没坏,是场景在骗它。
- 模型边界类:训练样本没覆盖的工况。训练集里皮带是干的,现场皮带偶尔带水反光,检出率立刻波动。张掖电厂做的"误报样本归集",归的就是这一类加上前两类。
- 规则配置类:检测区域画大了、报警阈值压得太低、联动条件写错。这不是算法问题,是实施问题,但它制造出来的误报和算法误报在告警列表里长得一模一样。
- 消费侧类:告警本身是对的,但推给了不该看的人、不该看的时间,值班员被高频低价值告警轰炸后开始"告警疲劳",真告警反而被淹没。
把五类放在一起看,结论很清楚:误报不是一个"bug",而是一组性质完全不同的工程问题。拿单一手段(比如统一调高阈值)去治五种病,只会把真告警一起压掉。
问题二:为什么"调完阈值就不管"是假治理?
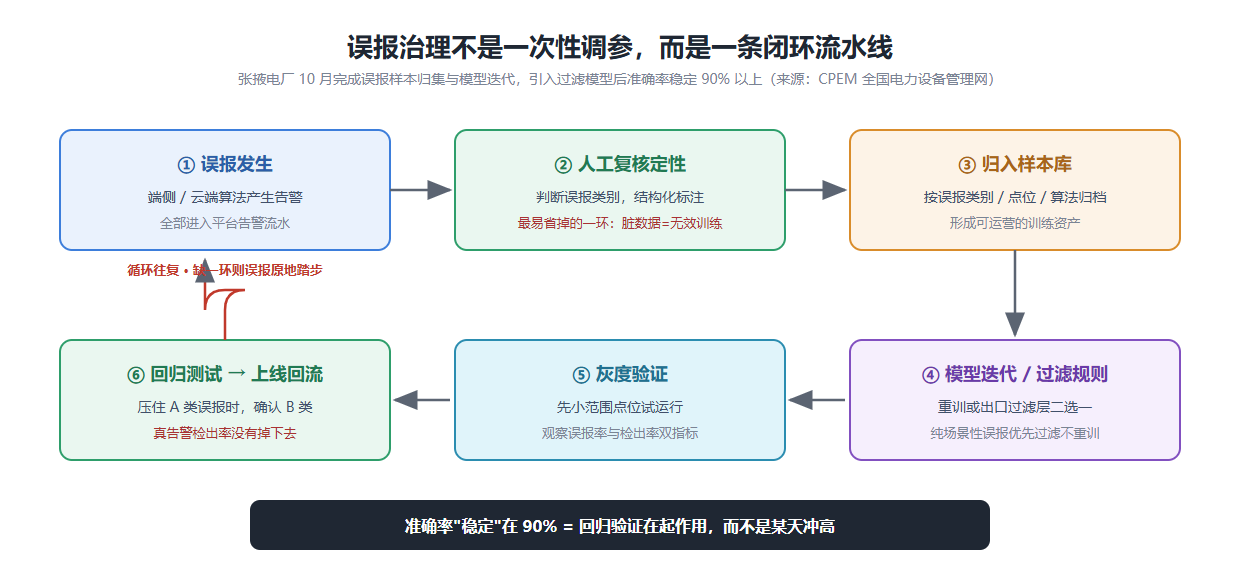
很多项目交付时的姿态是:上线、调阈值、验收、撤场。张掖电厂的报道给出的却是另一条时间线——算法上线之后,十月份还在做误报样本归集与模型迭代,而且是作为一项明确列出的工作而非临时救火。这说明治理不是一次性动作,而是一条闭环流水线:
误报发生 → 人工复核定性 → 归入样本库 → 模型迭代或过滤规则 → 灰度验证 → 回归测试 → 上线回流。循环往复,缺一环,误报就会在原地进行。
这条流水线里最容易被省掉的是两头。一头是"人工复核定性"——不看现场直接把误报标记扔进样本库,等于用脏数据继续训练;另一头是"回归测试"——新模型压住了 A 类误报,结果 B 类真告警的检出率掉下去,没有回归测试根本发现不了。张掖电厂报道里"准确率稳定保持"这个措辞,背后的潜台词就是回归验证在起作用:不是某天冲到 90%,而是稳定站在 90% 以上。
还有一点常被忽略:过滤不等于训练。有些误报不适合喂给模型重训(比如纯场景性的风扰),用一个独立的过滤层在告警出口做二次判定,成本远低于反复重训。张掖电厂"引入多语言过滤模型"的做法,本质就是在告警出口加了一道结构化的复核层。
问题三:治理动作放在端侧还是平台侧?
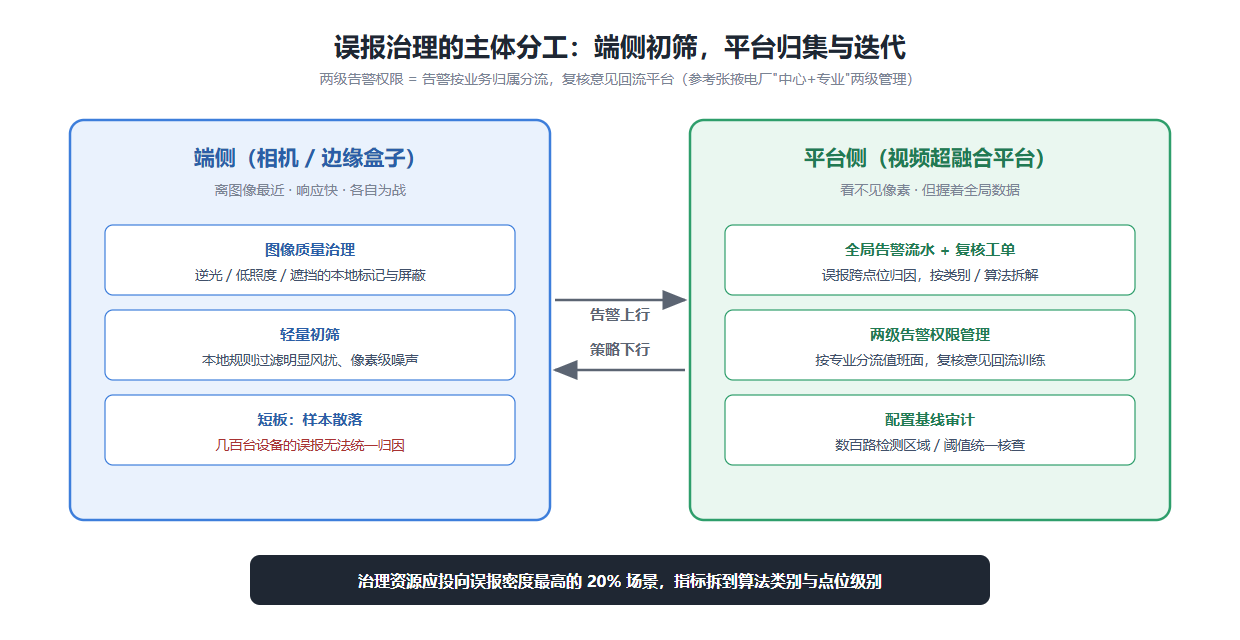
这是架构层面的真问题。端侧(相机内置算法、边缘盒子)离图像最近,改规则、换模型响应快;但端侧各自为战,样本散落在几百台设备里,谁也没法对全厂误报做统一归因。平台侧看不见原始像素,却握着三样端侧没有的东西:全局告警流水、人工复核工单、跨场景的误报归因视图。
张掖电厂的做法可以当参考答案读:平台侧建一体化智能巡检体系,把视频巡检、红外测温、四足机器人巡检和人工巡检协同起来,同时做了中心与专业两级告警权限管理。两级权限的意思是——告警先按业务归属分流,不同专业的值班员只面对自己领域的告警,复核意见再回流到平台。治理主体天然就分了工:
| 误报类别 | 典型表现 | 首选治理动作 | 治理主体 |
|---|---|---|---|
| 成像与环境类 | 逆光、雨雾、低照度下误检 | 图像质量监测 + 场景标签屏蔽 | 端侧为主,平台标记 |
| 场景语义类 | 水汽像烟、飘物像入侵 | 场景白名单 + 出口过滤层 | 平台侧过滤 |
| 模型边界类 | 新工况下检出率波动 | 误报样本归集 → 模型迭代 | 平台归集,端侧或云端重训 |
| 规则配置类 | 区域画错、阈值过低 | 巡检配置基线 + 变更审计 | 实施侧,平台审计 |
| 消费侧类 | 低价值告警轰炸值班员 | 分级推送 + 权限分流 | 平台侧 |
表格里最值得注意的一行是"规则配置类"。它不需要任何 AI 技术,却往往是现场误报的最大单一来源,而且只有平台侧能做统一的配置审计——三百多路视频的检测区域画没画错,逐台爬端侧配置是不现实的。
问题四:准确率 90% 之后,还差什么?
九成准确率听起来已经不错,但换算一下就知道没到松懈的时候。假设一个点位日均产生一百条告警,10% 的误报率意味着值班员每天要手工排除十条假警报;三百个点位、四十类算法叠加起来,误报的绝对数量仍会侵蚀信任。张掖电厂把准确率写进报道,恰恰说明这个指标在电力行业已经成了被监管和被考核的硬指标,而不是宣传话术。
往下一步是什么?是把准确率指标拆到算法类别和点位级别,让治理资源投向误报密度最高的那 20% 场景;是把人工复核从"排除误报"升级为"结构化标注",让每一次值班员点击都变成训练资产。到那一步,告警准确率就不再是算法厂商的性能参数,而变成视频平台自身的数据运营能力。
结语
把四个问题的答案连起来,这条治理链其实已经完整:误报按来源分五类治理,治理靠闭环流水线而不是一次性调参,流水线的归集与迭代放在平台侧、初筛与图像治理放在端侧,指标按类别与点位拆解持续运营。张掖电厂这堂"治理课"最有价值的启示就一句话——AI 视频识别项目的交付节点不是算法上线,而是误报治理体系上线。上线之后的第一天,才是治理的第一天。
智联视频超融合平台介绍
上面说的误报治理闭环,恰好就是视频超融合平台的价值所在:张掖电厂案例里"平台侧归集、端侧初筛、两级告警权限"的分工,与智联视频超融合平台的架构立场完全一致——平台向下把 GB28181/RTSP 等多协议的存量摄像头统一接入汇聚,让三百路甚至更多的点位在一张网里可管可控;平台向上则提供算法调度、告警分级推送与开放 API,让告警流水、复核工单、样本回流都在平台侧沉淀成数据资产,而不是散落在各台设备的固件里。对正在从"算法上线"走向"治理上线"的团队来说,一个能承接多源视频汇聚、又把告警治理留在平台侧的超融合底座,正是这堂课需要的教具。
智联视频超融合平台面向能源、电力、矿山、化工、园区等行业,提供视频接入汇聚、AI 分析调度、多协议转换与开放集成能力,支持存量摄像机利旧接入与云边端协同部署,帮助企业把分散的摄像头变成可运营的智能感知网络。
(完)