
11 月 1 日,中国环境网报道了环保展上的一套系统:首创智能的 AI 视频智能预警系统,靠大语言模型加视觉语言模型,把水务企业现有的监控摄像头直接变成"智能巡查报警员",号称不增加硬件预算、不改变一线操作习惯。
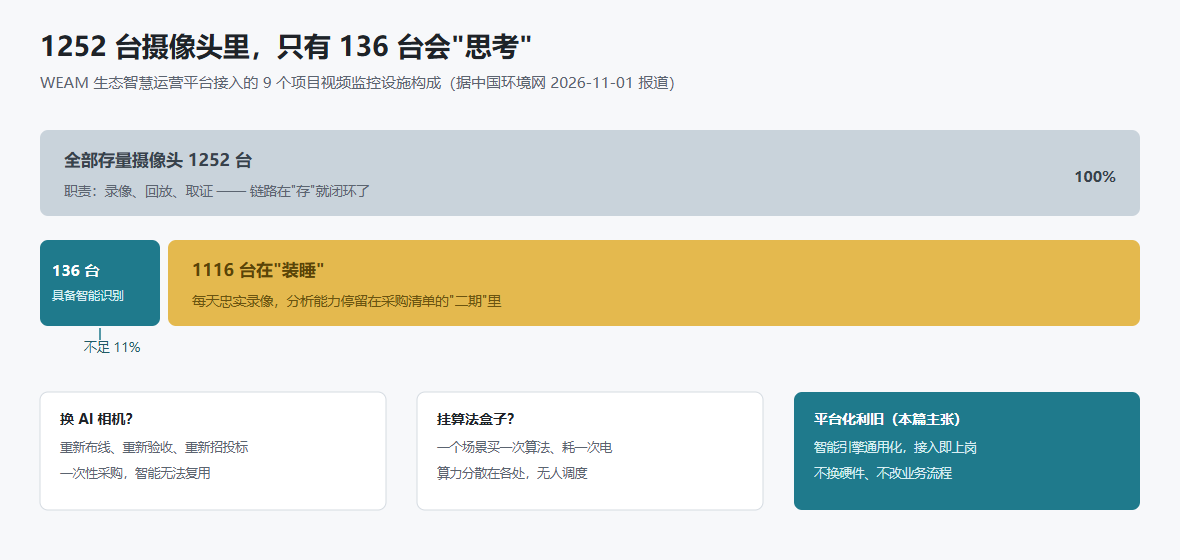
配套公开报道里有一组更扎心的数字:WEAM 生态智慧运营平台接入的 9 个项目,装了 1252 台视频监控设施,真正具备智能识别能力的只有 136 台——占比不足 11%。
剩下那 1116 台,每天忠实录像,在硬盘里等一个可能永远不会被调阅的明天。
这不是水务一家的病,是整个视频监控行业的通病。而"存量利旧"这道被讲了多年的题,首创这次给出的答卷值得拆一拆。我的看法先放这儿:存量利旧这道题,难点从来不在算法,在工程。下面按四个问题拆。
问题一:你的摄像头里,有多少台在"装睡"?
先回答为什么 89% 的摄像头是"装睡"的。
绝大多数存量监控系统的架构逻辑是"录像优先":摄像机把码流推给 NVR 或者存储服务器,落盘、回放、取证,链路就闭环了。要不要分析?那是后来加的需求,加的方式通常是两条路:要么换带 AI 能力的新相机,要么在前端后端单独挂算法盒子。
两条路都贵,而且贵得隐蔽:换相机要重新布线、验收、招投标;挂盒子是每个场景买一次算法,算力散落各处无人调度。于是大多数项目的选择是:先录着,智能化列入"二期"。
二期通常不会再来了。所以 1252 台里只有 136 台会思考,不是预算问题,是架构问题——智能能力从来没有被设计成可复用的平台层,它被当成了一次性采购项。
问题二:不换硬件,"看懂"从哪里来?
首创这次的路线核心是四个字:云边端协同。展开说,它做对了三件工程上的事。
第一,把识别引擎从"专用"改成"通用"。传统方案里每个场景一套小模型:漂浮物一个、排污一个、积水一个,各自训练部署。这套系统的底座是视觉语言模型加大语言模型,识别的语义理解能力是底座给的,场景差异主要靠提示词和样本去约束。这也是它敢说"让每一台现有摄像头都上岗"的底气——引擎通用了,接入才是主要工作量。
第二,样本策略务实。它没有追求通用大模型开箱即用,而是融合千余路存量视频资源和公开数据集,分场景构建"黄金数据样本",再设计图像识别提示词。也就是说,大模型负责"看懂",行业数据负责"看准"。这一步省不掉,也恰恰是平台厂商该干的活。
第三,工程化模块去兼容存量业务平台,而不是要求业务系统迁就它。这点不起眼,却决定利旧能不能落地——甲方工单、告警、值班制度都已在跑,没人愿意为接 AI 推倒业务流程。
| 维度 | 传统小模型改造 | 视觉大模型利旧升级 |
|---|---|---|
| 识别引擎 | 每场景单独训练专用模型 | 通用底座 + 提示词约束场景 |
| 硬件投入 | 换 AI 相机或加算法盒子 | 复用现有摄像头,不加硬件 |
| 扩展新场景 | 重新采集标注、重新训练 | 补样本、调提示词为主 |
| 算力形态 | 分散在盒子/边缘,难调度 | 云边端协同统一调度 |
| 与业务系统 | 各自对接,烟囱式 | 工程化模块兼容现有平台 |
问题三:单靠画面,判得住吗?
答案很明确:判不住,必须融合。这是这套系统里最值得其他行业抄的一笔。
三个场景的正确率结构很说明问题:
| 场景 | 融合的数据源 | 实测判别正确率 |
|---|---|---|
| 水面漂浮物识别 | 纯视频画面 | 约 83% |
| 排口异常出流 | 视频画面 + 雨量计数据 | 约 88% |
| 道路积水识别 | 视频画面 + 雨量计 + 气象预报 | 约 85% |
水面漂浮物只靠画面,就能做到全天候运行,在江苏宿迁、淮安两地 49 个监控点上跑出了 83% 的判别正确率。但排口出流不一样——下雨天排口出水是正常的,非降雨时段出水才可疑,所以系统把雨量计数据融合进来,"看见出水却难以追溯来源"的老问题才被解决。道路积水更进一步,把气象预报也接进来,降雨过程中按积水深度分级触发。
看出来了吗?视频是主证据,但让判定成立的是视频之外的数据。单一模态的 AI 视频分析,天花板就在那里;跨数据源的融合判定,才是从"识别"走向"业务可用"的那一步。
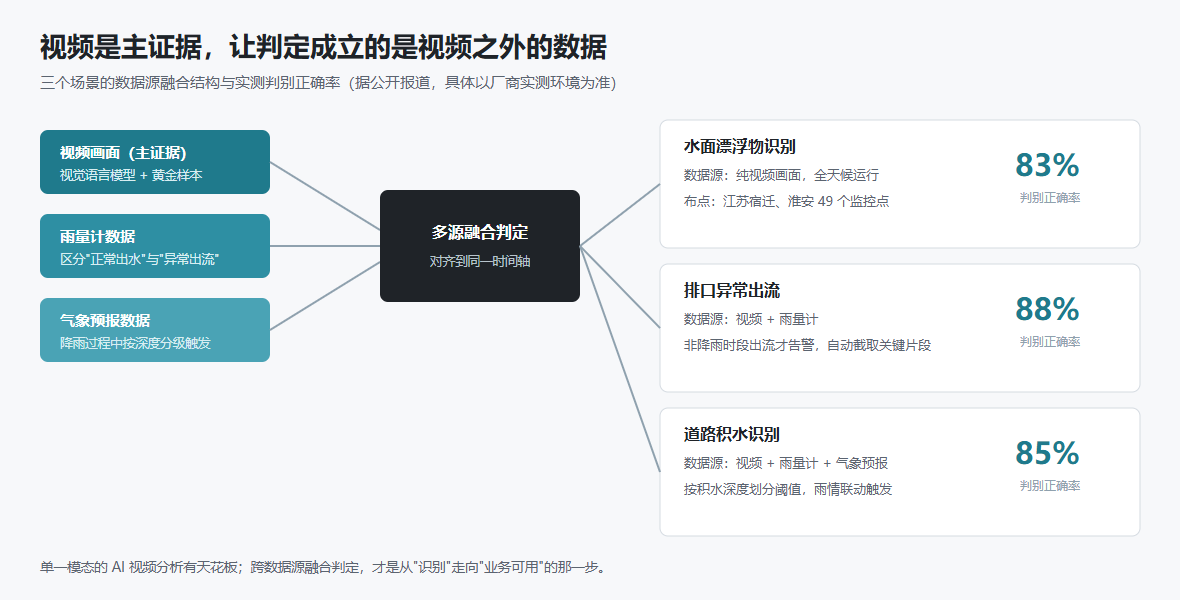
这对视频平台的架构要求很直接:接入层不能只收码流,得能收 IoT 数据、气象数据,并且在一个判定流程里把它们对齐到同一时间轴上。
问题四:告警之后,谁接住?
识别只是开始,告警发出来没人管,比不发还糟——它会迅速消耗值班人员对系统的信任。
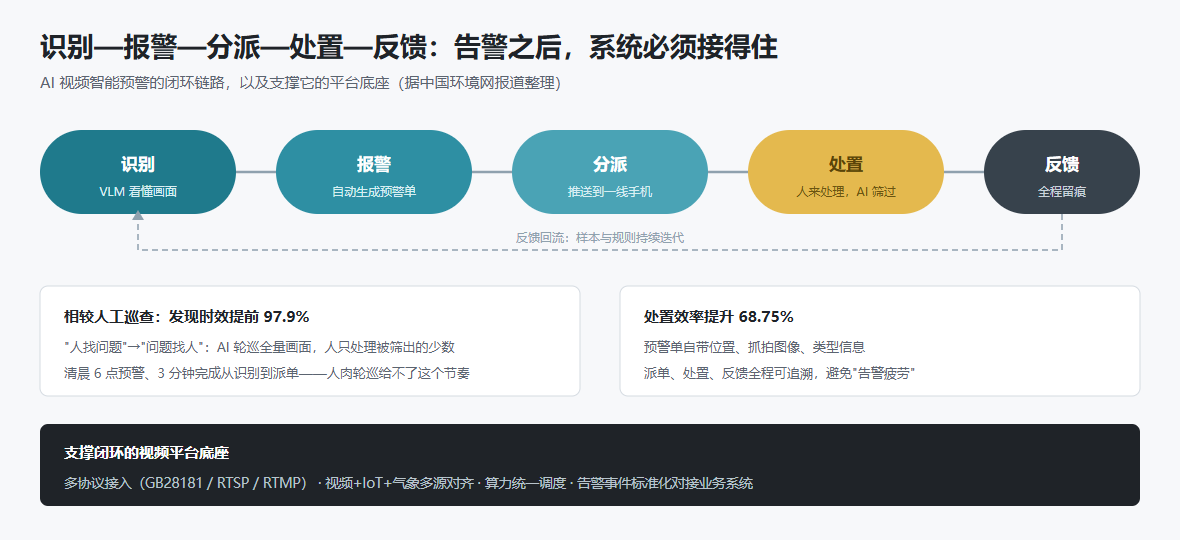
这套系统的答案是五个环:识别—报警—分派—处置—反馈。识别出异常即自动生成含位置、抓拍图、类型信息的预警单,推送一线运维手机,派单、处置、反馈全程留痕。公开报道给出的对比数字是:相较人工巡查,发现时效提前 97.9%,处置效率提升 68.75%。
这两个数字背后是两种工作模式的区别:人工巡查是"人找问题",巡到哪里算哪里;闭环系统是"问题找人",AI 轮巡全量画面,人只处理被筛出来的那一小撮。上午 6 点大屏出红色预警、3 分钟完成从识别到派单,这个节奏人肉轮巡给不了。
顺带一提,同一个展台上还有个不太起眼的应用叫"智能问数":业务人员用自然语言问"B 厂 3 号提升泵近一年的维修记录",系统直接调取设备参数、缺陷、保养、维修履历作答,单位时间有效数据获取量提升 5 到 10 倍。视频预警解决"看见",数据问数解决"听懂"——大模型在视频行业落地,从来不只是一个摄像头的事。
收个尾:四个问题,其实是一张架构清单
回过头看这四个问题,答案是同一个:
- 摄像头"装睡",是因为智能能力没有平台化;
- "看懂"要成立,靠的是通用引擎加行业样本加工程化兼容;
- 判定要可信,靠的是视频与 IoT、气象数据的多源融合;
- 告警要闭环,靠的是把 AI 事件接进真实的业务流程。
所以我的结论是:存量利旧的竞争力,不比谁的算法分高,比谁的接入、融合、调度、闭环这四层工程是否扎实。钱包从"换设备"挪到"接平台",这可能是未来几年视频行业最大的一笔结构性转移——毕竟会思考的摄像头,从来不心疼旧。
顺势介绍一下我们自己在做的事。智联视频超融合平台就是按上面这张架构清单来设计的:GB28181、RTSP、RTMP 等多协议统一接入,存量摄像头利旧注册,视频流在平台内统一转码、分发与调度;AI 分析以调度方式挂接在平台之上,识别结果与告警事件走标准接口对接到业务系统,形成从接入到闭环的完整链路。如果你的项目里也躺着一大批"装睡"的摄像头,欢迎来聊聊怎么用一张平台网让它们集体上岗。
(案例数据来自中国环境网 11 月 1 日报道及首创智能公开资料,指标以厂商实测为准。)