
10 月 16 日,百度智能云在西安的超级智能体大会上披露了"百度一见"在中国铁路西安局集团的落地数据:设备巡检场景下,智能体半小时可分析 3000 张高清图片,异物检出率不低于 95%,误报率控制在不高于 5%;站台安全管控场景下,旅客越线后 2 秒内锁定异常并触发声光警报。同场还宣布了百度一见 6.0 开放内测,以及一款 AI 原生具身智能相机。据华商网报道,远元集团也签约在全国近 10000 家连锁门店部署这套系统,覆盖 80 余个检查场景。
数字好看是一回事。作为每天跟视频接入、转码、分发打交道的人,我更关心的是这条链路本身怎么搭、瓶颈卡在哪、视频平台在其中承担什么角色。这篇文章就把这三件事拆开说清楚。
一、先算一笔旧账:"一场景一模型"为什么走不动
铁路是典型的重资产、强安全行业,专业多、点位散、场景碎。按报道里的说法,过去的做法是"一个场景一个模型、一个团队各管一段":针对接触网异物、站台越线、设备表计各自立项,从方案设计、数据标注到模型训练,专业算法工程师要投入数月。
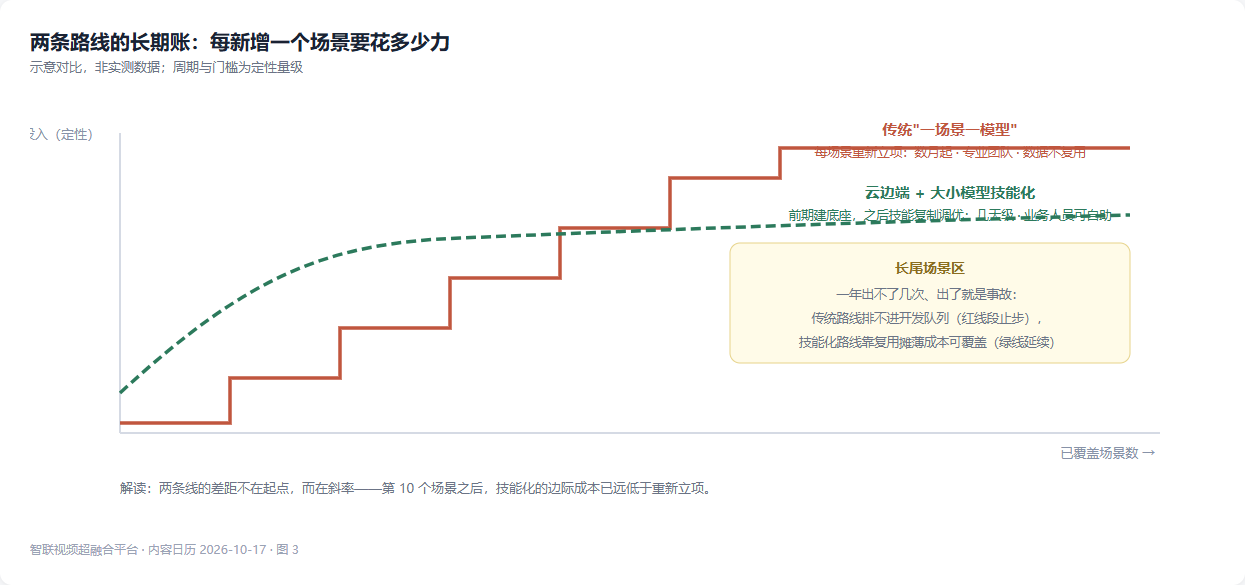
这笔账算下来有两个结构性问题。第一是成本不收敛:每个新场景都要重新走一遍数据闭环,一线的长尾场景——那种一年出不了几次、但出了就是事故的场景——永远排不进开发队列。第二是数据不流动:接触网上识别鸟窝的经验,对站台越线毫无帮助,模型之间没有复用,标注数据也沉淀不下来。
这不是铁路独有的问题。电力、化工、矿山这些行业的视频 AI 项目,几乎都在同一个坑里。海康在大模型方案里讲"小模型初筛、大模型复核",解决的是误报;百度这次讲的"技能沉淀",解决的是开发门槛。两家切入点不同,但都在回答同一个问题: 长尾场景的 AI 覆盖,靠堆人力是算不过账的。
二、三层链路拆解:这套系统到底怎么跑
把报道里的描述拼起来,百度一见的架构可以拆成三层来看。
第一层,边缘侧初筛。视频流在靠近现场的位置完成初步过滤,只有可疑目标才往上传。这一层决定了带宽成本——3000 张高清图如果全量上云,铁路沿线的网络条件撑不住,先把量压下来是所有边云协同方案的第一原则。
第二层,云端大模型复检。边缘筛出来的候选目标交给大模型做精细判别,结合多维度信息综合判断。样本不足的长尾场景靠大模型的泛化能力补齐训练数据,这也是"检出率 95%、误报 5%"这组数字能同时成立的前提:单靠小模型,检出率和误报率是跷跷板,大模型复核把两头同时按住。
第三层,技能沉淀与复用。这是本次最有意思的部分。按报道,非算法工程师可以在几天内训练、调优场景模型并沉淀为"技能";百度一见 6.0 更进一步,支持业务人员基于现场图片、视频和自然语言描述直接生成、调优视觉检测技能。也就是说,接触网巡检练出来的技能,可以整体复制到另一个铁路局、另一类厂站,调优工作量远小于从零训练。
整条链路画出来是这样的:
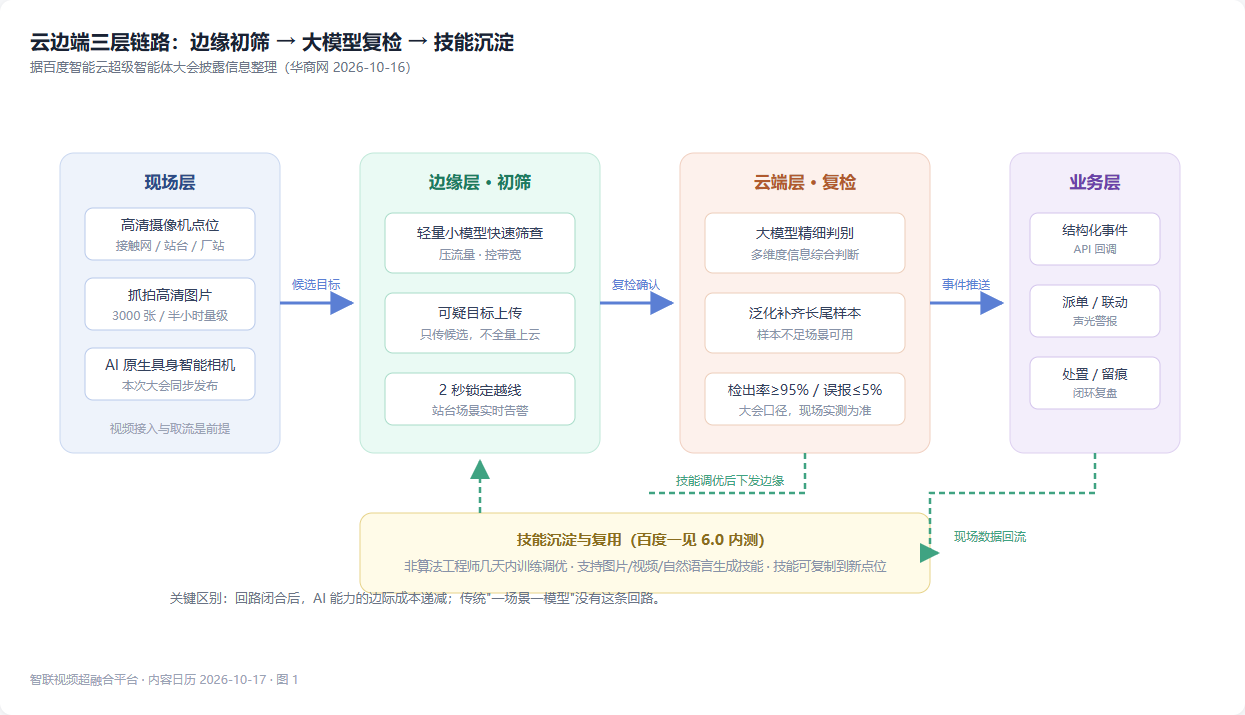
注意中间那条向下的回路:现场数据回流 → 技能调优 → 再下发到边缘。链路闭环跑起来之后,AI 能力的边际成本是递减的——这正是它和"一场景一模型"的本质区别。
三、一张表看清两种路线的差别
把传统小模型路线和这套云边端技能化路线放在一起对比:
| 维度 | 传统一场景一模型 | 云边端 + 大小模型技能化 |
|---|---|---|
| 开发主体 | 专业算法工程师 | 业务人员可自助(6.0 支持自然语言生成技能) |
| 单场景周期 | 数月起(设计+标注+训练) | 几天内训练调优并沉淀为技能 |
| 样本依赖 | 每场景足量标注数据 | 长尾场景可用大模型泛化补数据 |
| 长尾覆盖 | 排不进开发队列,基本放弃 | 技能复用摊薄成本,可覆盖 |
| 误报治理 | 小模型单打,检出与误报难两全 | 边缘初筛 + 大模型复核双层过滤 |
| 能力迁移 | 模型间不复用 | 技能整体复制到新点位/新单位 |
表格里的每一行,在西安铁路的落地里都有对应物。这张表也可以当作甲方评估视频 AI 项目的 checklist:厂商讲方案时,逐行问过去,讲不清楚"技能怎么沉淀、长尾怎么覆盖"的,多半还是老路线套了个新名词。
两条路线的差距,画成一条线看得更清楚:
四、别只看算法:视频侧要交出什么
看热闹的多,看门道的少。AI 识别再准,前提是视频链路先把活干好。报道里有一句容易忽略的话:智能体分析的对象是"高清图片"——这些图片从哪来、时间戳可不可信、事件能不能及时回传业务系统,全是视频侧的责任。要让这类云边端 AI 真正跑起来,视频联网平台至少要交出五样东西:
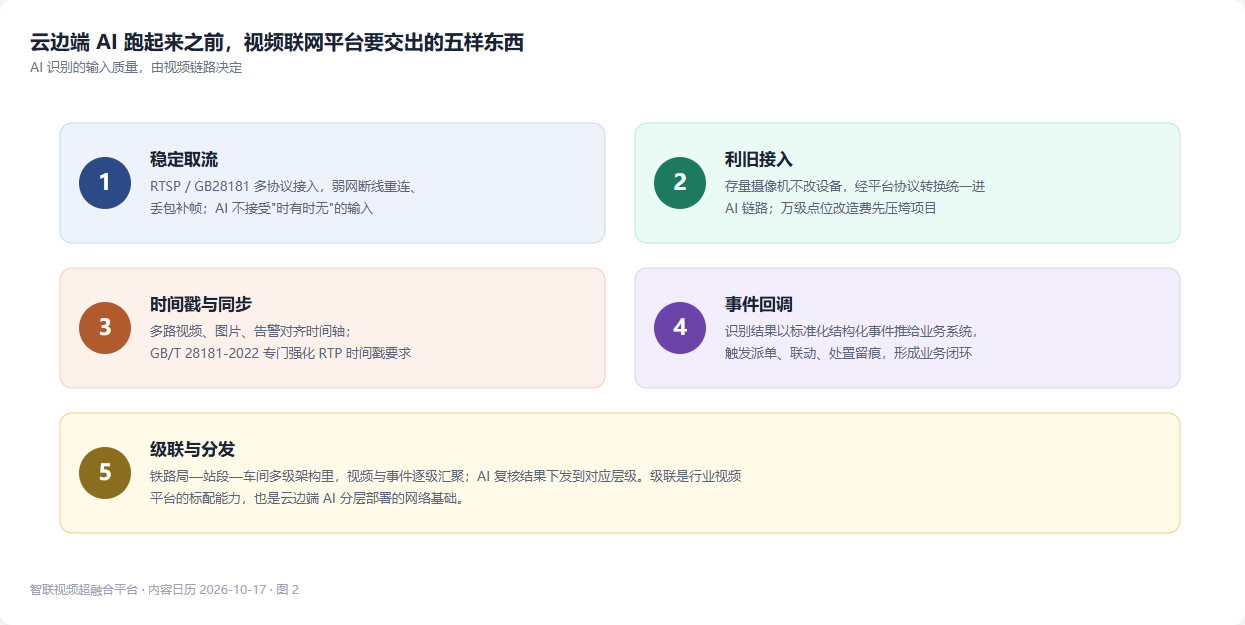
- 稳定取流:RTSP/GB28181 多协议接入,弱网下断线重连、丢包补帧,AI 不接受"时有时无"的输入;
- 利旧接入:存量摄像机不改设备,经平台协议转换后统一进 AI 链路,否则近万个点位的改造费用先压垮项目;
- 时间戳与同步:多路视频、图片、告警事件要对齐时间轴,国标 2022 版专门强化了 RTP 时间戳要求,就是为了保这条底线;
- 事件回调:识别结果要以标准化结构化事件推给业务系统,触发派单、联动、处置留痕,形成报道里说的完整闭环;
- 级联与分发:铁路局—站段—车间的多级架构里,视频和事件要能逐级汇聚,AI 复核的结果也要能下发到对应层级。
这五项没有一项在 AI 的叙事里上头条,但没有它们,识别准确率再高也只是实验室数字。
五、数字怎么读:95% 和 5% 的分寸
最后聊聊怎么读这些数字。检出率不低于 95%、误报不高于 5%,是厂商在大会口径下的表述,具体到不同点位、不同光照条件下的表现,需要以现场实测为准——这一点和所有 AI 项目的评估一样,宣传数字和验收数字之间通常有距离。
但方向值得肯定: 误报率和检出率被当成一组指标同时报告,而不是只报好看的那个。回想 G7 易流把月度报警从 887 条治理到 590 条的案例,误报治理才是 AI 视频项目能否活下去的生命线——运维人员被"狼来了"消耗三轮之后,再准的系统也会被关掉声音。
接下来的观察点有两个:一是百度一见 6.0 内测的实际使用门槛,"业务人员自然语言造技能"是真到可用,还是演示状态;二是 11 月 12 日百度世界大会是否会给出更多行业的规模化数据。10000 家门店的部署是第一个压力测试,餐饮门店场景杂、环境变化快,比铁路巡检的标准化点位难得多,跑通了才有说服力。
结语
西安铁路这单落地,价值不在那两个数字,而在它验证了一条路径:AI 视觉能力从"算法团队的项目制交付"走向"业务侧的技能化生产"。对视频行业的人来说,这意味着平台的角色在变——从视频的搬运工,变成 AI 生产的供给侧:供稳定流畅的流、供可信的时间轴、供结构化的事件通道、供低成本利旧的接入方式。算法在谁手里会不断变化,这四样东西不会。
智联视频超融合平台介绍
上述链路里视频平台要交出的五样东西,正是智联视频超融合平台的日常。作为面向视频联网场景的超融合平台,它以 GB28181/GB35114/ONVIF/RTSP 多协议接入打底,存量摄像机利旧直连,单机支撑千路级并发接入与转码分发,内置国标级联、时间戳对齐与标准化事件回调接口,可与 AI 边缘盒子、云端大模型服务灵活组网,覆盖能源、电力、矿山、化工、交通、园区等行业场景的"视频接入—结构化—业务闭环"全链路。如果您的现场正在评估云边端协同的视频 AI 方案,欢迎了解智联视频超融合平台的接入方案与实测数据。