
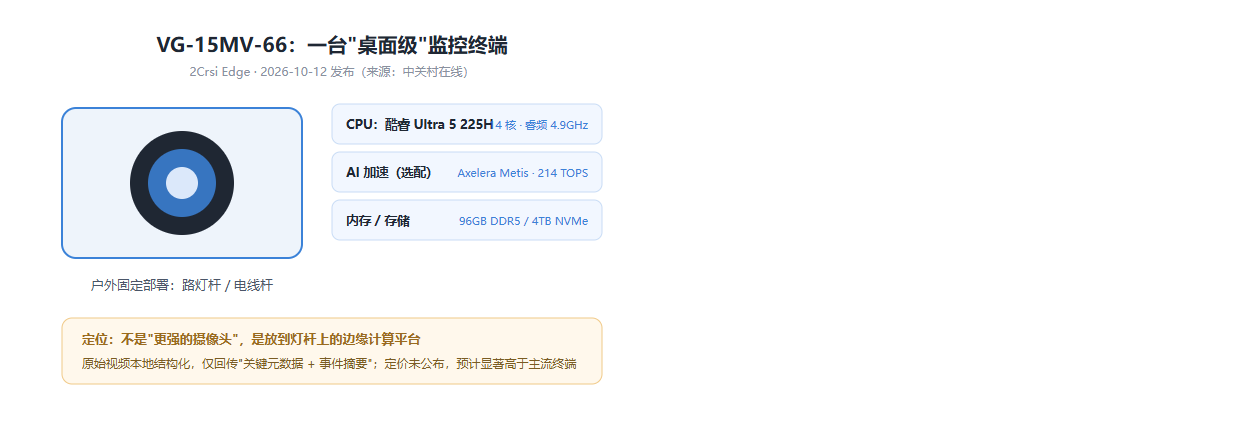
10 月 12 日,英国厂商 2Crsi Edge 发布了一台叫 Vision Guard VG-15MV-66 的监控摄像头。它之所以被行业媒体关注,不是因为画质、不是因为夜视,而是因为肚子里塞了一颗英特尔桌面级处理器——酷睿 Ultra 5 225H,14 核心,睿频 4.9GHz,还能选配 M.2 接口的 Axelera AI 加速卡,把整机算力推到 214 TOPS。中关村在线的评价很直接:这是目前唯一一台"理论上具备运行 3A 游戏能力"的监控终端。
消息传开,评论区两极分化:一边说"安防卷到这个程度纯属浪费",一边说"这就是边缘计算的未来形态"。我先把话说在前面:这两种说法都不对。这台设备真正的信号,不是"摄像头要多强",而是"算力下沉这场仗,已经打到最前端了"——但下沉的边界在哪里,行业里还没人说清楚。今天这篇就试着把这条边界画出来。
一、这不是噱头,是算力下沉的第三级台阶
先把 VG-15MV-66 的配置摆出来看,你就明白厂商在想什么了。
按照官方口径(中关村在线 10 月 12 日报道),这台设备的定位是"面向安防场景的高性能边缘计算平台",而不是传统的视频采集装置。96GB DDR5 内存、4TB NVMe 或 8TB SATA 存储、可以只向后台回传"关键元数据与事件摘要"——这套组合拳的意图非常明显:把原本放在中心服务器的视频结构化分析,整个搬到灯杆上。
回顾这十年的边缘 AI 演进,其实是一条清晰的三级台阶:
- 第一级:摄像机内置 DSP 跑专用小模型——人脸抓拍、车牌识别,算法写死,一个场景一套模型;
- 第二级:SoC 集成 NPU——4~8 TOPS 的端侧算力,让摄像头能同时跑几种轻量算法,海康、大华、宇视这三年的智能摄像机基本都停在这一级;
- 第三级:就是 VG-15MV-66 这种,直接把通用计算平台塞进前端——算力上不封顶,算法随便换,甚至能上传私有模型。
为什么有人开始爬第三级台阶?因为第二级有个绕不过去的天花板:端侧 NPU 的算力是"预分配"的。出厂标多少 TOPS,就是多少 TOPS,想跑更大的多模态模型?换硬件。这与安防行业"算法半年一迭代、模型一年一大换"的节奏是矛盾的。把桌面级平台放前端,等于用通用计算的可升级性,对冲专用芯片的迭代风险。
逻辑是通的。但问题来了:算力下沉,是不是越下沉越好?
二、算力下沉的三层账本
架构判断不能只看技术可行性,要算账。我把"前端算力、边缘盒子、云端中心"三条路线的账本摆在一起:
| 维度 | 前端算力(每路摄像头自带) | 边缘盒子(若干路共用一台) | 云端中心(全量回传集中算) |
|---|---|---|---|
| 典型算力形态 | 摄像头内嵌 CPU/NPU,如 VG-15MV-66 | 100~500 TOPS 边缘服务器 | GPU 集群/机房 |
| 时延 | 毫秒级,就地处理 | 十毫秒级,局域网内 | 百毫秒级起,看带宽 |
| 单路成本 | 最高,且随路数线性增长 | 中等,多路分摊 | 硬件便宜,带宽和存储贵 |
| 带宽占用 | 最低,只回传结构化结果 | 中等,视频不出园区 | 最高,原始流全量上传 |
| 算法升级 | 受限于单机算力,逐台升级 | 集中升级,池化调度 | 最自由,算力弹性扩容 |
| 数据边界 | 最好,原始画面不出设备 | 好,不出园区 | 差,全量出网 |
| 适合场景 | 点位少、隐私敏感、布线困难 | 园区/厂区中等规模汇聚 | 城市级大规模联网 |
这张表看下来,规律其实很清楚:前端算力的优势全部来自"单点",劣势也全部来自"单点"。一台 VG-15MV-66 再强,它也只是把一路摄像头的算力问题解决了;而一个真实项目动辄几百上千路,逐台堆桌面级 CPU,成本曲线是线性上涨的,运维对象也从"几台服务器"膨胀成"几千台异构终端"。英国厂商没公布定价,但按酷睿 Ultra 5 加 Axelera 加速卡的物料清单,"显著高于主流监控终端"是行业媒体的共识——这个"显著"放到千路项目里,就是一笔没法过评审的预算。
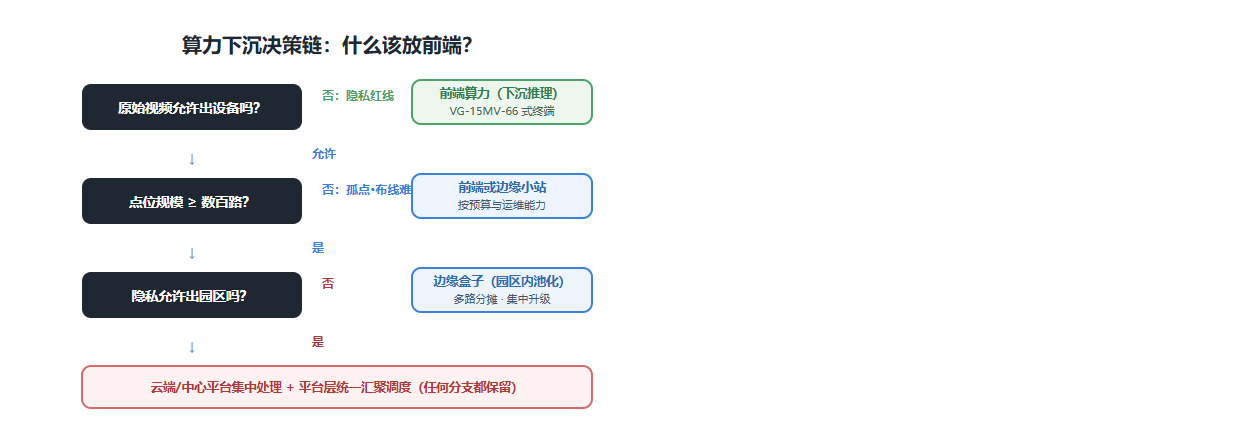
所以第三级台阶爬得对,但只适合爬在特定的点位上:布线困难、隐私红线严格(原始视频根本不允许出设备)、算力需求极端个性化的孤点场景。灯杆上的一台哨兵式摄像机,可以;一个几千路的园区,不可以。
三、该下沉的是推理,不该下沉的是汇聚
聊到这里,可以把我的核心观点端出来了:算力下沉这场仗,"推理"该往下打,"汇聚"一步都不能让。
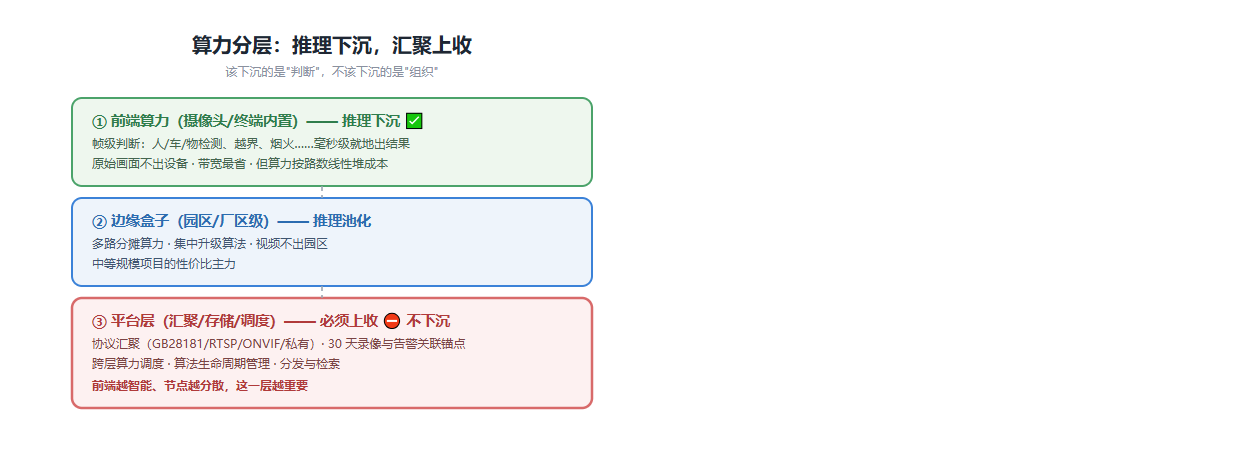
推理是什么?是"这一帧画面里有没有人越界"的判断。它离数据越近越好:时延低、带宽省、隐私可控。VG-15MV-66 把 214 TOPS 放到前端,抢的就是这块地盘,方向没问题。
汇聚是什么?是把几百路异构摄像机的视频流、告警流、设备状态流,统一收上来、管起来、存下来、按需分发出去。这件事恰恰不能下沉,因为它天然是"全局"的:
- 协议汇聚是全局的——GB28181、RTSP、ONVIF、厂家私有协议,一个项目里往往同时存在,只有平台层有能力做混合接入和统一编址,单台前端设备永远只认识自己;
- 存储是全局的——推理可以在前端,但 30 天录像、告警与原始画面的时间戳关联,必须有一个集中可信的锚点,否则事后取证就是灾难;
- 调度是全局的——算法 A 跑在 1 号摄像机、算法 B 跑在边缘盒子、模型 C 在云端复核,这种跨层调度只有平台能做,前端设备再强也只是被调度的对象。
现在一些前端厂商的叙事容易误导人:"算力都在摄像头里了,还要平台干什么?"这是把两件事混为一谈。前端算力解决的是"看得懂",平台解决的是"管得住、找得到、连得上"——前者是推理问题,后者是系统问题。算力越下沉,系统里异构、分散的智能节点就越多,对统一汇聚与调度的需求反而越强,不是越弱。
四、趋势预判:TOPS 不是胜负手,开放性才是
最后给一个判断,留给未来 12 个月验证。
前端算力的竞争,接下来不会卷 TOPS 数字——214 TOPS 这种参数,明年就会被人翻倍超越,没有护城河。真正的胜负手是算力的开放性与可编程性:能不能上传私有模型、能不能被第三方平台远程调度、算法生命周期能不能被统一管理。海康把 HEOP 嵌入式开放平台做进硬件,本质上就是在赌同一个方向——硬件不再卖算力,卖的是"可被编排的算力"。
反过来看 VG-15MV-66 们要补的课,恰恰是开放性的短板:桌面级平台装进户外设备,功耗、散热、防雷、远程运维,每一项都是传统安防厂商踩了十几年的坑。一颗能跑 3A 游戏的 CPU 解决不了这些问题,一套懂现场的视频基础设施才能。
一句话收束:算力下沉到摄像头,是推理的胜利,不是平台的终结;前端越智能,越需要一个能把智能"组织起来"的汇聚层。摄像头聪明了,但聪明不该是散装的。
智联视频超融合平台介绍
把镜头从英国拉回国内——上面说的"把散装的智能组织起来",正是智联视频超融合平台每天在做的事。行业里的存量摄像机协议五花八门,GB28181、RTSP、RTMP、ONVIF、国网 B 接口乃至厂家私有协议并存,平台做混合接入,把海康、大华、宇视等各品牌设备统一汇聚,前端算力再怎么升级换代,视频这一层先收稳、管好;视频按需分发给任意 AI 算力做结构化,不管是端侧、边缘盒子还是云端大模型,告警结论与原始录像在同一平台内按时间戳关联,既能一句话搜结论,也能一键回放原始画面取证。推理交给越跑越强的前端,汇聚交给专业平台,两层各司其职——这既是本文的架构判断,也是平台的产品立场。
本文事实来源:中关村在线 2026-10-12《英国发布首款搭载桌面级 CPU 的 AI 监控终端 VG-15MV-66》。文中未标注出处的行业判断为作者观点。