
一、一个被"半小时同步"改变的操作习惯
先说一个真实项目。
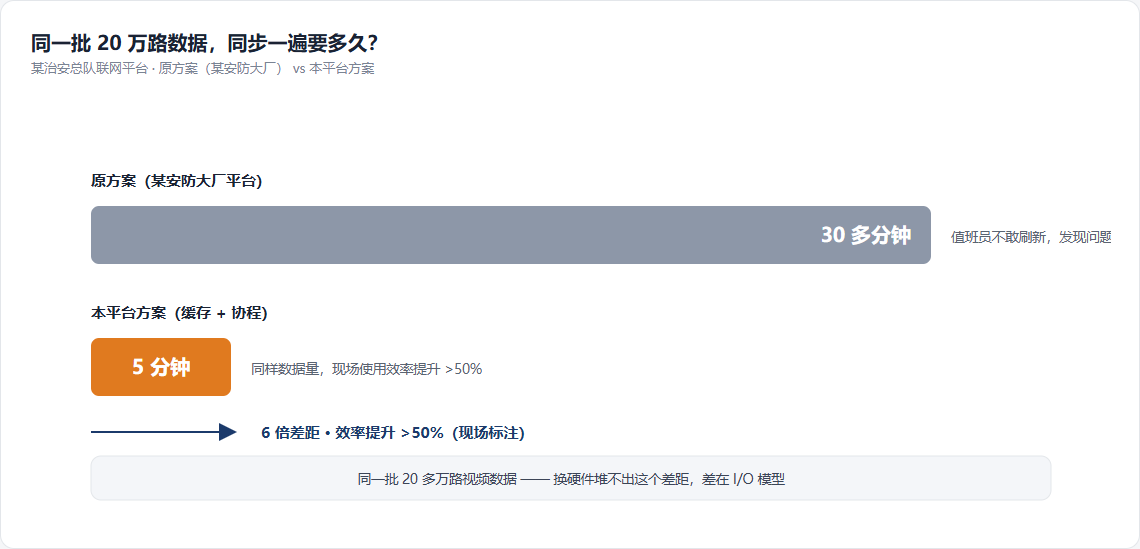
某治安总队联网平台,下级平台要往上汇聚 20 多万路视频数据。原方案用的是某安防大厂的平台,每次从下级同步一遍视频数据,需要 30 多分钟。
30 多分钟意味着什么?意味着值班员的操作习惯会变形:不敢频繁刷新,怕点了卡住;发现问题要等下一轮同步,一等就是半小时。一个平台用久了,人会迁就它的脾气——这不是功能问题,这是体验倒逼出来的将就。
后来换成新方案,同样的 20 万路数据,同步时间压到 5 分钟左右,现场使用效率的提升超过 50%。
同样的数据量,为什么差了 6 倍?
我的判断很直接:这不是硬件堆料能解决的差距。 把服务器换一圈、带宽翻一倍,30 分钟大概率还是 30 分钟。真正的问题在别的地方。
二、汇聚慢的真相:三个环节在排队
拆开看,"平台汇聚慢"通常不是带宽不够,而是三个环节在排队。
第一,数据拉取是串行的。 逐个下级平台轮询,一级拉完再拉下一级,20 万条数据走完全流程才落库。任何一个下级响应慢,整条流水线跟着等。
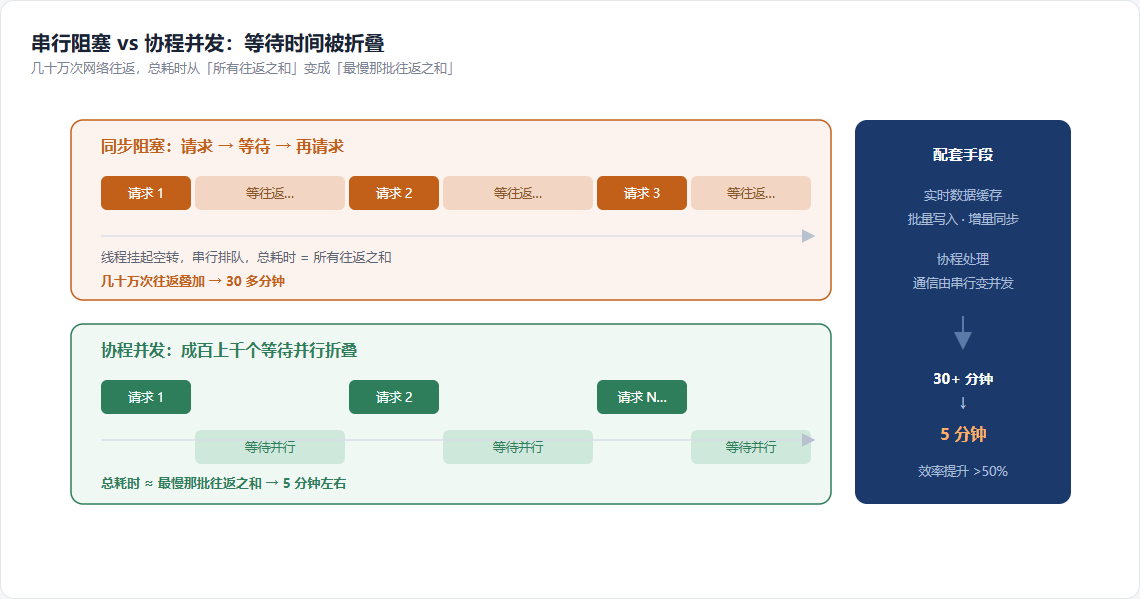
第二,通信是同步阻塞的。 每发一个请求,线程就挂在那里等网络往返,等到才发下一个。单次往返几十毫秒看着不多,几十万次往返叠加起来,就是把大量时间花在"空转等待"上。
第三,落库和展示没有缓冲。 一边写入一边被查询,锁竞争把写入方和查询方一起拖慢。很多平台在演示环境里很快,一到几十万路的真实规模就原形毕露,根子都在这里。
所以我的观点是:大多数"平台汇聚慢",本质是 I/O 模型问题,不是服务器不够强。 用堆硬件去解 I/O 模型的问题,钱花了,慢还在。
三、我们做的两件事
回到上面那个项目,解法其实就两件事,都写进了产品方案里:
| 环节 | 做法 | 效果 |
|---|---|---|
| 数据吞吐 | 实时数据缓存,批量写入与增量同步 | 减少落库次数与锁竞争 |
| 网络通信 | 协程处理,把串行等待变成并发等待 | 几十万次网络往返的等待时间被折叠 |
| 结果 | — | 30 多分钟 → 5 分钟左右(现场同步效率提升 >50%) |
实时数据缓存解决的是吞吐:下级推上来的数据先进缓存,攒批落库,写入和查询互不踩脚。
协程处理解决的是通信:发起请求后不等一个往返结束再发下一个,成百上千个等待并行折叠在一起。串行变并发,总耗时从"所有往返之和"变成"最慢那批往返之和",这就是 6 倍差距的主要来源。
这两件事没有一件听起来玄乎,但要把它们在国标级联、多厂家异构的真实环境里做稳,比写 demo 难得多。
四、数据说完了,还有三类"看不见的慢"
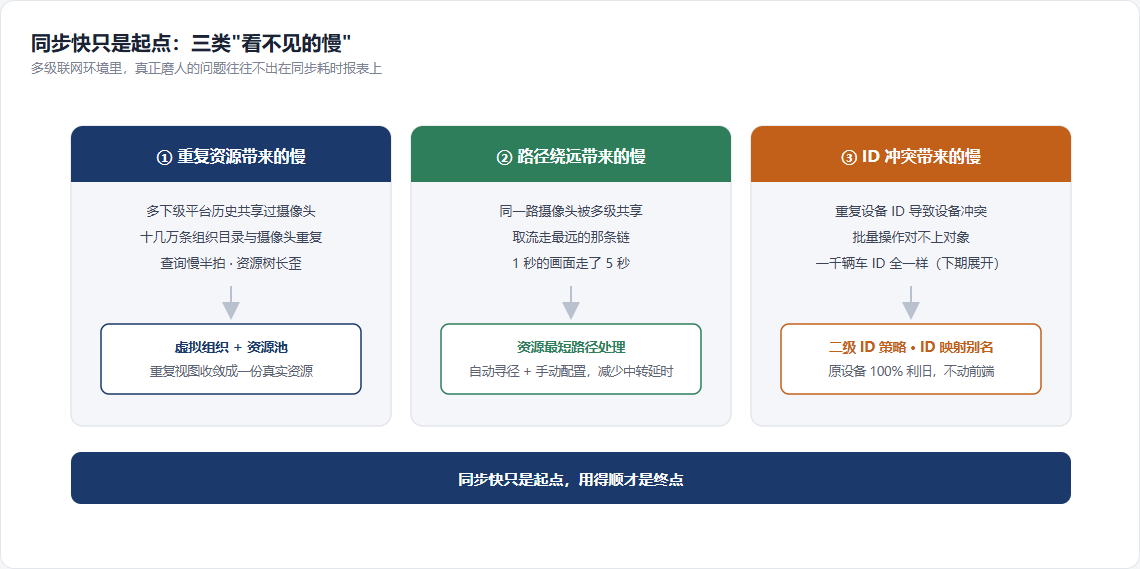
同步时间只是显性指标。真实的多级联网环境里,还有三类慢不容易被报表看见,但一样磨人。
一是重复资源带来的慢。 多个下级平台之间历史上共享过摄像头,几轮共享下来,十几万条组织目录与摄像头是重复的。查询本身就慢半拍,管理员面对一棵长歪的资源树。解法是虚拟组织与资源池,把重复视图收敛成一份真实资源。
二是路径绕远带来的慢。 同一路摄像头被多级共享后,取流可能走最远的那条链,本来 1 秒能出的画面走了 5 秒。解法是资源最短路径处理:自动寻径加手动配置,减少网络中转延时。
三是 ID 冲突带来的慢。 重复的设备 ID 导致设备冲突和管理混乱,批量操作经常对不上对象。这个话题水很深,一千辆特勤车国标 ID 全一样的场景,我们下一期专门展开。
同步快只是起点,用得顺才是终点。
五、给架构师的四条判断标准
如果你正在选汇聚平台,或者正在评估自己平台的汇聚能力,我给四条判断标准:
第一,同步是"全量"还是"增量 + 缓存"? 全量同步在这个量级上没有前途,问清楚增量机制和缓存策略。
第二,通信模型是同步阻塞还是协程/异步? 这一条直接决定规模上限,也最难后补。
第三,有没有去重和最短路径策略? 还是说要靠人工整理十几万条重复的组织树?
第四,49 万路这个量级,见过真实跑起来的案例吗? demo 环境和真实联网环境之间,隔着无数多厂家、多网段、不规范实现的坑。
四条问下来,谁在纸上谈兵、谁真跑过大盘,基本就分出来了。
写在最后
上面这套"缓存 + 协程 + 去重 + 最短路径"的思路,智联视频超融合平台在 20 万路、49 万路这类海量汇聚场景中已经跑通——某大数据局感知平台接入 49 万路视频资源,涵盖海康、大华、宇视等多个厂家平台,对接十多个下级平台、三个上级平台,实现三级平台对接;某治安总队平台接入 22 万路,覆盖摄像机、车载图传、执法仪、警务手机等多种设备类型。
到目前为止,平台已累计接入 100 万+ 路视频,落地 10+ 行业、100+ 项目。分布式架构加流媒体技术支撑高并发低延迟,汇聚、分发、转码、智能识别、存储和运维在同一个底座上完成——海量数据不是接进来就完了,还要用得快、用得顺。
你的平台同步一遍要多久?欢迎留言或私信,报个路数,我们聊聊瓶颈在哪。