
一、先接受一个反直觉的事实:绝大多数画面什么都没发生
做视频 AI 的人,最容易犯的错误是用"平均情况"去做架构设计。
真实的监控画面是什么样?一条产线,摄像头连续几个小时没有违规;一段周界,一整晚只有风吹草动;一个厂区大门,大部分时间只有正常进出的人。
如果按"每一路每一帧都需要被理解"来设计系统,你就会得出一个荒谬的结论:需要给每一路视频配一个大模型。
算力账单会先把你劝退。以 3000 路为例,就算只按每秒抽一帧、每帧一次多模态推理来估算,这个成本也没有哪个项目能长期承担。
更关键的是,监控判断里大量任务是确定性规则:"人员进入禁区""车辆越线""未佩戴安全帽持续 3 秒"——这类任务不需要开放式推理,固定规则加时序逻辑反而更准、更稳、更便宜。
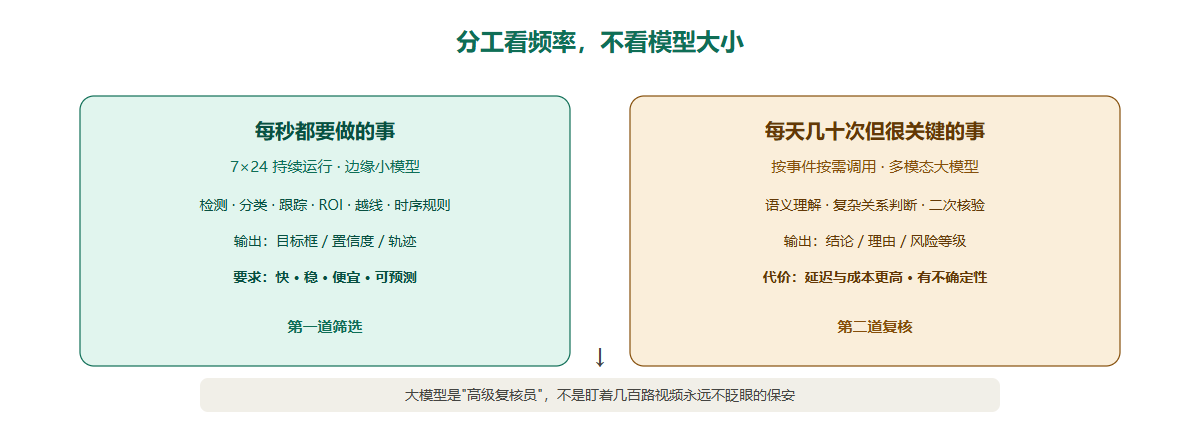
所以大模型在这个体系里的角色,不是"盯着几百路视频永远不眨眼的保安",而是**"高级复核员"**。
二、分工的唯一原则:按任务频率,而不是按模型大小
很多人纠结"小模型该干多少、大模型该干多少",其实这个问题的答案不在模型本身,而在任务发生的频率。
- 每秒都要做的事:交给轻量、稳定、可预测的模型
- 每天只出现几十次、但一旦出现就需要复杂判断的事:交给大模型
| 能力维度 | 边缘小模型 | 多模态大模型 |
|---|---|---|
| 运行方式 | 7×24 小时持续运行 | 按事件、按需调用 |
| 主要任务 | 检测、分类、跟踪、ROI、越线、时序规则 | 语义理解、复杂关系判断、二次核验 |
| 输出 | 目标框、类别、置信度、轨迹、规则结果 | 结论、理由、风险等级、结构化说明 |
| 优势 | 快、稳定、成本低、确定性强 | 理解能力强,可结合文本规则与上下文 |
| 弱点 | 复杂语义和开放场景能力有限 | 延迟和成本更高,输出存在不确定性 |
| 最适合的位置 | 第一道筛选 | 第二道复核 |
这张表背后是一条更底层的原则:确定性要求越高的环节,越应该用可解释、可预测的模型。
能源、化工、矿山这类场景尤其如此。它们的共同点是——误报的代价是人的注意力被消耗,漏报的代价可能是事故。这两个方向都不能靠"模型自己发挥"来解决。
三、五层链路:一个能真正跑起来的架构
把上面的分工落成架构,大概是五层。
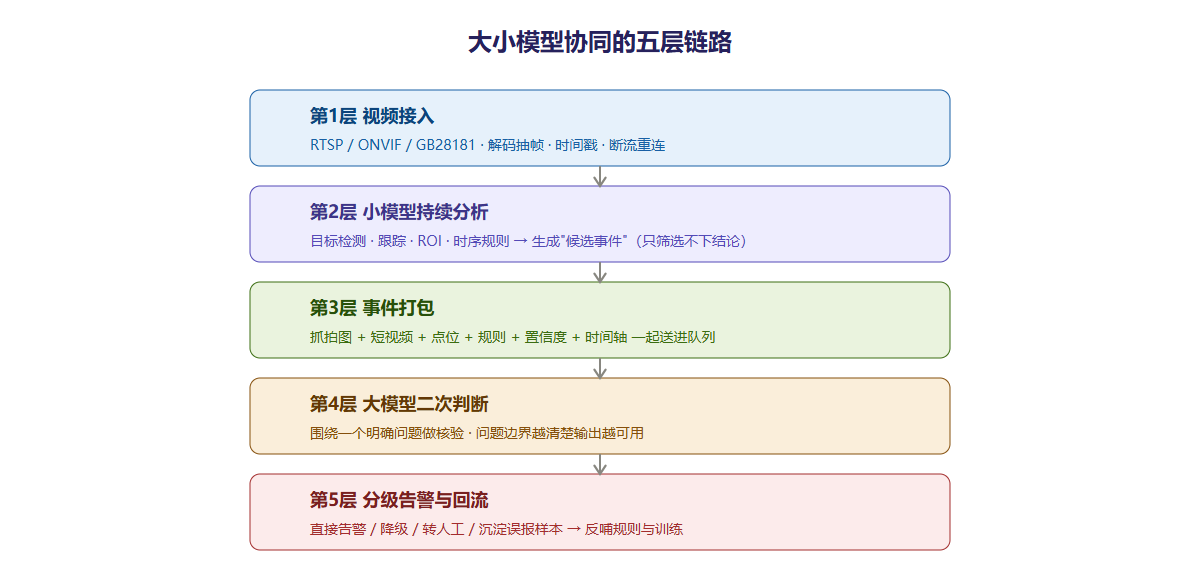
第 1 层,视频接入。 摄像机或 NVR 通过 RTSP / ONVIF / GB28181 提供视频流。这一层要做的是最枯燥但最要命的活:解码、抽帧、时间戳对齐、断流检测与自动重连。视频平台 80% 的"玄学问题"都出在这一层。
第 2 层,小模型持续分析。 边缘侧模型负责人员、车辆、安全帽、烟火、区域入侵等目标检测,结合跟踪、ROI、目标尺寸、持续时间、时段等规则,生成"候选事件"。
注意这里的关键词是候选。小模型不负责下结论,它负责把可疑的东西挑出来,并且保证不漏掉真正重要的。
第 3 层,事件打包。 只有值得复核的事件才进入队列,并且必须携带足够上下文:抓拍图、全景图、短视频片段、摄像头点位信息、生效的区域规则、前端检测结果与置信度。
第 4 层,大模型二次判断。 多模态大模型围绕一个明确问题做判断:"该人员是否确实未佩戴安全帽""画面中的亮斑更接近火焰还是阳光反射"。问题的边界越清楚,大模型的输出就越可用。
第 5 层,分级告警与回流。 根据复核结果决定:直接告警、降低告警等级、转人工确认,或者沉淀为误报样本。人工反馈再回流到规则和小模型训练,形成闭环。
四、最常踩的坑:只把一张抓拍图丢给大模型
这是我在项目里见到最多、也最可惜的浪费。
很多团队做二次核验的方式是:拿一张抓拍图,加上一句"有没有违规?",然后期待大模型给出准确判断。
结果通常不理想。因为大模型缺了三样东西:
时间上下文——这是一瞬间的动作还是持续了很久? 空间上下文——这个点位在哪,周边有什么,这条规则针对哪个区域? 前端置信度——小模型当时有多确定?
没有这三样,大模型只能靠"猜图",那它的表现当然不如一个规则写得好的小模型。
正确的做法是:把事件当成一个包,而不是当成一张图。图、短视频、点位、规则、置信度、时间轴,一起送进去。这不是为了多喂数据,而是为了让模型在一个被约束的问题空间里做判断。
五、2026 年的新变量:Agent 和轻量级大模型开始下沉边缘
今年一个明显的变化是,边缘硬件的定位正在发生迁移。
过去边缘盒子的核心定位是"视频结构化硬件"——跑 YOLO 系列算法,做人脸、安全帽、烟火、越界识别,输出告警和抓拍图。能力边界很清楚:感知加简单规则告警。决策、摘要、复盘、业务编排全部依赖云端,断网之后只剩基础检测。
现在的趋势是,轻量化大模型加 Agent 框架开始落到边缘硬件上,边缘盒子从"视觉分析设备"变成"现场智能体运行底座",具备感知—理解—推理—决策—工具调用—执行的闭环。视频识别变成其中一项子能力,而不是全部能力。
| 维度 | 传统边缘盒子 | 新一代 Agent 边缘盒子 |
|---|---|---|
| 核心能力 | 目标检测、行为识别、视频结构化 | 视觉识别 + 本地 LLM/VLM + Agent 任务编排 |
| 运行逻辑 | 摄像头输入 → 算法推理 → 告警抓拍 | 多源输入 → 理解 → 任务拆解 → 工具调用 → 处置动作 |
| 网络依赖 | 复杂业务必须上云,断网只剩基础识别 | 离线可完整运行,云边协同做汇总下发 |
| 输出物 | 告警、截图、录像、结构化 JSON | 事件研判报告、巡检文档、故障诊断建议、控制指令 |
但要泼一盆冷水。
边缘能离线跑,不等于边缘的结论就一定对。能源、化工这类高安全要求场景里,三条底线不能松:
- 安全规程高于模型判断——模型的建议不能绕过既定的作业规程
- 权限边界必须硬编码——不能让 Agent 自由决定"要不要停机"
- 人工接管通道必须始终可用——包括通信中断时
那篇谈能源 AI 的报告里有一句话我很认同:大模型输出具有一定不确定性,而能源生产要求关键操作可追溯,需要工程手段建立可审计机制。也就是说,Agent 落地的前提不是模型能力,而是审计能力和责任边界。
六、给视频联网平台的四条改造建议
结合上面的分析,如果你们正在做或准备做视频联网平台的智能化改造,我建议从这四件事入手:
第一,先把"事件"作为一等公民建模。 平台的数据模型里,事件应该是独立对象,有自己的 ID、时间轴、上下文、处置状态、复核结论。而不是告警表里的一行记录。
第二,把计算放在正确的位置。 高频确定性计算放边缘,低频复杂判断放中心或云。不要因为云上有大算力,就把所有推理都往云上搬——带宽和时延会先教你做人。
第三,留好"结论不确定"这个状态。 很多系统的设计只有"告警/不告警"两种输出,这逼着模型在信息不足时必须做二分判断。三级甚至四级的状态设计(确定 / 疑似 / 待人工 / 已排除)会显著降低一线对系统的抵触。
第四,把人工反馈当成产品能力,而不是运营负担。 一线每次点"这是误报",都应该是训练数据的来源,而不是一次无意义的点击。没有回流机制的系统,准确率永远停在交付那天。
七、结语
大小模型协同这个词听起来很技术,但它要解决的问题其实很朴素:怎么用可接受的成本,让系统在 99% 的时间里安静,在 1% 的关键时刻可靠。
小模型负责看,大模型负责判断,人负责定规则和兜底。三层各守其位,这个体系才可能长期活着——而"长期活着",才是智能视频项目真正的验收标准。
写在最后:这套思路,我是在平台上验证过的
上面讲的"小模型筛选 + 大模型复核 + 事件打包",不是我画在白纸上的理想架构,而是我们在智联视频超融合平台里实际跑过的链路。
做视频平台的人都明白一个道理:算法再好,接不进来的视频都是零。 所以我们在这个平台上的第一优先级,是把接入这件事做透:
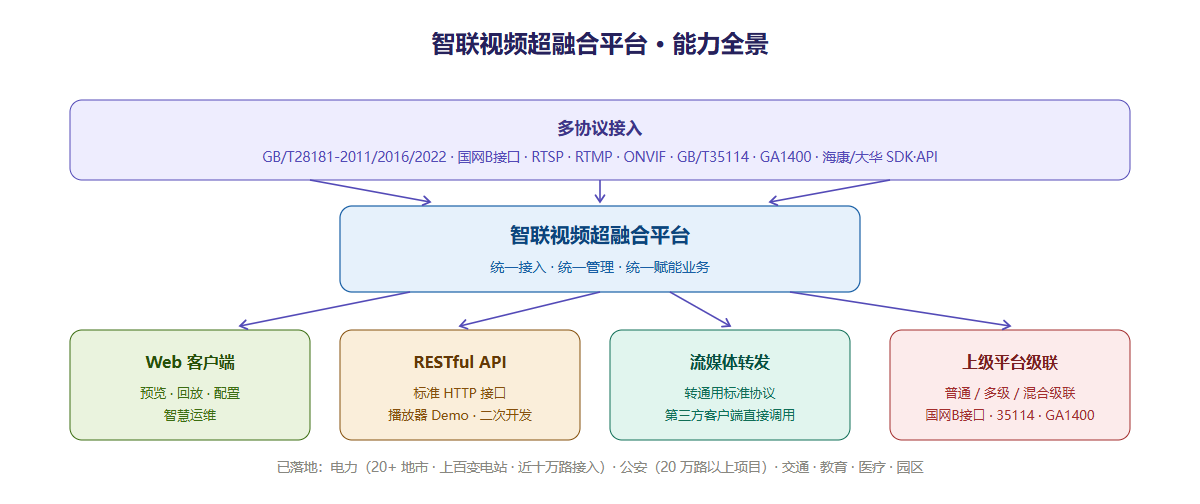
- 通过 GB/T28181-2011/2016/2022、国网B接口、RTSP、RTMP、ONVIF、GB/T35114、GA1400、海康/大华 SDK/API 等方式,接入海康、大华、宇视等各厂家摄像机、录像机、直播手机和下级平台,用 Web 客户端完成预览、回放、配置和智慧运维;
- 提供标准 RESTful HTTP API 和 Web 播放器 Demo 支持二次开发,并把音视频数据转成各种通用标准流媒体协议,让第三方客户端可以直接调用;
- 支持按 GB/T28181、国网B接口、GB/T35114、GA1400 对接上级平台,普通级联、多级级联、混合级联都支持;
- 已经在电力、公安、交通、教育、医疗、物联网、智慧城市、智慧园区等行业落地——电力行业在全国多个省区二十多个地市部署,上百个变电站和集控中心接入十多个厂家的设备,视频接入总数接近十万路;公安行业跑过多个二十万路以上的项目。
五层链路里最难的不是第 4 层的大模型,而是第 1 层和第 3 层。接入做不稳,事件打包做得不完整,大模型拿到的上下文就是残缺的,复核结论也就不可信。 这是我最想传达给同行的经验。
欢迎在评论区聊聊你们在大小模型协同上踩过的坑。